2014年6月18日水曜日

Amazon Elastic Block Store (EBS) で SSD がデフォルトになりました。


既にあちこちで取り上げられていますが、Amazon Web Service (AWS) のブロックストレージサービスである、Amazon Elastic Block Store (EBS) で SSD がデフォルトで利用できるようになりました。

マニュアルや料金表、SIMPLE MONTHLY CALCULATORも改版されています。

オンプレ環境と比較して速度的に劣るといわれていたEBSも、これで汚名を挽回できるでしょうか?

もちろんインスタンスのルートボリュームとしても利用できます。
(突然マネジメントコンソール上での、インスタンスウィザードからインスタンスを起動しようとしたら、SSDも選べるけどどうする?みたいなポップアップがでて大騒ぎしてしましました。)

もちろん30GB までの無料使用権も付いています。

EBSのタイプ

これまで "standard" ボリュームと表記されていたEBSタイプは、"Magnetic" と表記されるようになりましたが一覧表示等では、これまで通り "standard" と表示されるようです。

このアップデートでEBSのボリュームタイプは以下の3種類になります。
ボリュームタイプAPIと CLIのボリューム名
General Purpose (SSD)gp2
Provisioned IOPS (SSD)io1
Magneticstandard

さらに従来の standard ボリュームではわずかですが、IO量に応じた従量課金がありましたが、今回から廃止されました。プロビジョンしたディスク容量だけの課金となります。

EBSの性能

性能に関してはこれまでの standard ボリュームから大きく改善されています。最大 3000 IOPS のバースト性能を持ちます。これまでは Provisioned IOPS (PIOPS) を利用しない場合バーストでも数百 IOPS でしたから10倍以上の改善となります。バーストなので利用できるIOPSに制限がありますが、最低でもおよそ30分程度は継続して利用できます。

もっとも今時のSSD製品では数万IOPSを掲げる製品も出てきているので、今後の改善を期待したいところです。

IOPSの帯域制御は IO Credits という非常にユニークな方法を採用しています。

利用可能なIOPSは1GB あたり 3 IOPS が毎秒追加されます。例えば300GBのEBSを用意したとすると、毎秒 900 IOPS が追加されます。IOPSは一秒間にIOした回数なので、最低でも 900 IOPS は利用できるわけです。

一方利用しなかったIOPSは、最大 5,400,000 IOPS分まで蓄積できます。蓄積されたIOPSは最大3000IOPSまで一度に消費できます。

300 GBの EBS ならば、900 IOPS は最低利用できるので、3000 - 900 = 2100 IOPS が消費されるます。5,400,000 ÷ 2,100 = 2571.4... なので、およそ42分ぐらいは、バーストを継続できます。もちろん最大 1 TB = 1000 GB を確保すると、毎秒 3000 IOPSをずっと利用できるわけです。

このバースト性能が向上しているのは LINUX で ext4 のようなファイルシステムを利用している場合は非常に有利です。

ext4 は、基本的にはIOPSを可能な限り押さえるように動作します。そのためメモリ上にたくさんバッファしておいてあるときにまとめて書き出すようになっています。

メモリが不足してバッファを解放するような処理を実施したときに大量のIOPSが一時的にそれも間欠的に発生する場合があります。

このときプロセスはメモリ獲得待ちになりIOが完了するまで待たされます。

これはプロセスが直接メモリ獲得要求を実施した場合だけでなくシステムコールの延長線上で一時的なメモリ確保が発生した場合でもメモリ獲得待ちになり処理遅延につながります。最悪 OOM Killer の餌食になってしまいます。

そのような場合に一時的にでも多くのIOPSが使えると非常にシステム上は有利になります。

コスト

コスト的には、東京リージョンで 1GB あたり 1ヵ月 $0.12です。
100GB利用して月1000円ぐらいです。

120GBのSSDが8000円台で入手できることを考えると少し高い気がしますが、自分で設置したり、故障交換したりデータセンターに置いたりのコストを考慮すると、まぁ妥当な値段かと思います。

ただ注意しなければいけないのは PIOPS (io1) との使い分けです。

例えば、io1 で100GB で 1000 PIOPS プロビジョニングすると

容量  $0.142 × 100GB      = $14.2  
PIOPS $0.074 × 1000 PIOPS = $74 
合計                         $88.2 
(7月からの新料金で計算)

になります。一方で GP2 で 400 GB 相当確保した場合は容量課金だけなので

$0.12 × 400GB =$48 

です。これで 400GB × 3 IOPS/GB なので、1200 IOPS 確保できて、
容量も 4 倍なので非常にお得感があります。

もっとも PIOPSのようにIOPSを保証するとは言っていないのでその点は考慮する必要がありますが、3000 IOPS を超えるような IO 帯域が常時必要なユースケースは限られるので、名前の通り通常は GP2 を選択して問題ないのではないでしょうか。

また standard ボリュームからみると、値上がりしていますが 10 倍程度の性能差と 100 GB あたり $4 程度の差分なのでよほどコストにシビアでない限り GP2 を選択することになるとおもいます。

もしコスト重視ならば EBS ではなく S3 や Glacier の利用もできるので、standard ボリュームが選択される機会は減っていくのではないでしょうか。

また IOPS を重視するならば、いっそデータをファイルに置かずに、Dynamo DB に格納してしまうという方法もあります。

小さなデータを大量に読み書きする場合は、PIOPS を利用するよりも安くなるユースケースもあるとおもいます。何よりもストレージのサイズを気にしなくてよくなります。

Introducing the Amazon EBS General Purpose (SSD) volume type

【AWS発表】新しいSSDベースのElastic Block Storage

【超速報】Amazon EBSに「SSD」が追加されてるぞ!

Amazon Elastic Block Store (Amazon EBS) (マニュアル)

Amazon EBS Volume Types

Amazon EBS の価格

SIMPLE MONTHLY CALCULATOR

Intel SSD 320 Series (600GB, 2.5in SATA 3Gb/s, 25nm, MLC)

2014年5月30日金曜日

EBS で暗号化がサポートされたのでベンチマークしてみた。

Amazon Web Service (AWS) のブロックストレージサービスEBSで暗号化がサポートされました。
使い方はとても簡単 EBS を作成するときに Encryption チェックボックスにチェックを入れるだけ。


一覧表示でもEncrypt の項目が追加されています。


残念ながら、ルートボリュームでは利用できないようです。


気になるのは暗号化による性能劣化です。マニュアルにも以下の記載があります。

 you can expect the same provisioned IOPS performance on encrypted volumes as you would with unencrypted volumes with a minimal effect on latency.
暗号化ボリュームでも最小限のレイテンシで暗号化していないボリュームと同じプロビジョンドIOPS性能を期待できる。
実際に iozone で測定してみました。使用したインスタンスサイズは、m3.midium です。
まずは暗号化なしの場合。


こんな感じです。大きくへこんだところがあるのは多分の測定時に何か撹乱要因があったのでしょう。
次は暗号化ありの場合


ほとんど違いが分かりません。ちなみにこれは書き込みの場合をグラフ化したものです。
読み込みはほとんどIOPSが出ず、メモリに収まった感じだったので、省略します。

ファイルシステムを利用した場合は、ワークロードによっても影響度が変わってくると思いますが、暗号化のオーバーヘッドはほとんど無視できるようです。


2014年5月20日火曜日

Amazon Web Service (AWS) で一つの EC2 インスタンスにいくつ EBS がつけられるか試してみた。

EC2インスタンスに何個EBSがつけられるの?

Amazon Web Service (AWS) で 一つのEC2インスタンスに何個 EBS がくっつけられるのかマニュアルを探してみたけれど、以下の記載しかなくどうもはっきりしたことが分からないので、実際にためしてみた。

やってみる

Management Console から インスタンスウィザードを起動して、"Step 4: Add Storage"のところで、"Add New Volume" を連打した。"/dev/sdb" からはじまり、"/dev/sdz" を通り過ぎて "/dev/xvdz" が表示されたあたりで、このあたりで許してあげようと思い "Launch Instance"。

結果

一見インスタンス自体は問題なく起動しようとしているように見える。がいつまでたってもSSHログインできない。get system log をみると以下のように、Bug を踏んでいた。
4394230.182195] kernel BUG at fs/sysfs/group.c:65!
[4394230.182198] invalid opcode: 0000 [#1] SMP
[4394230.182203] Modules linked in:
[4394230.182207] CPU: 0 PID: 19 Comm: xenwatch Tainted: G        W    3.10.35-43.137.amzn1.x86_64 #1
[4394230.182215] task: ffff88002492c710 ti: ffff880024936000 task.ti: ffff880024936000
[4394230.182219] RIP: e030:[<ffffffff811eb772>]  [<ffffffff811eb772>] internal_create_group+0x202/0x230
[4394230.182228] RSP: e02b:ffff880024937c50  EFLAGS: 00010246
[4394230.182232] RAX: 0000000000000400 RBX: ffff880003544000 RCX: 0000000000000000
[4394230.182236] RDX: ffffffff8184dfc0 RSI: 0000000000000000 RDI: ffff880003544080
[4394230.182241] RBP: ffff880024937c88 R08: 00000000000163c0 R09: ffff8800260163c0
[4394230.182245] R10: ffffea0000927d00 R11: ffffffff81311bb2 R12: ffff880003590000
[4394230.182250] R13: ffffffff8184dfc0 R14: 0000000000000000 R15: ffff880003544070
[4394230.182259] FS:  0000000000000000(0000) GS:ffff880026000000(0000) knlGS:0000000000000000
[4394230.182264] CS:  e033 DS: 0000 ES: 0000 CR0: 000000008005003b
[4394230.182268] CR2: 0000000000000000 CR3: 000000000180c000 CR4: 0000000000002660
[4394230.182273] DR0: 0000000000000000 DR1: 0000000000000000 DR2: 0000000000000000
[4394230.182277] DR3: 0000000000000000 DR6: 00000000ffff0ff0 DR7: 0000000000000400
[4394230.182281] Stack:
[4394230.182284]  ffff880003544080 ffffffff81256951 ffff880003544000 ffff880003590000
[4394230.182291]  ffff880003544000 ffff880003544070 ffff880003544070 ffff880024937c98
[4394230.182298]  ffffffff811eb7b3 ffff880024937ca8 ffffffff810f84b4 ffff880024937ce8
[4394230.182305] Call Trace:
[4394230.182311]  [<ffffffff81256951>] ? kobj_kset_leave+0x51/0x60
[4394230.182316]  [<ffffffff811eb7b3>] sysfs_create_group+0x13/0x20
[4394230.182324]  [<ffffffff810f84b4>] blk_trace_init_sysfs+0x14/0x20
[4394230.182331]  [<ffffffff8123ecfd>] blk_register_queue+0x3d/0x110
[4394230.182336]  [<ffffffff81245a0d>] add_disk+0x1cd/0x4a0
[4394230.182341]  [<ffffffff81324a1d>] blkback_changed+0xd3d/0x1010
[4394230.294407]  [<ffffffff812da098>] xenbus_otherend_changed+0x98/0xa0
[4394230.294418]  [<ffffffff812dc083>] backend_changed+0x13/0x20
[4394230.294433]  [<ffffffff812d9436>] xenwatch_thread+0xb6/0x170
[4394230.294440]  [<ffffffff81070e10>] ? wake_up_bit+0x30/0x30
[4394230.294454]  [<ffffffff812d9380>] ? unregister_xenbus_watch+0x230/0x230
[4394230.294462]  [<ffffffff8106fee0>] kthread+0xc0/0xd0
[4394230.294477]  [<ffffffff8106fe20>] ? kthread_create_on_node+0x120/0x120
[4394230.294485]  [<ffffffff8144a12c>] ret_from_fork+0x7c/0xb0
[4394230.294498]  [<ffffffff8106fe20>] ? kthread_create_on_node+0x120/0x120
[4394230.294503] Code: 8b 7d d0 89 4d c8 e8 8e e7 ff ff 4c 8b 65 d0 8b 4d c8 e9 28 ff ff ff 4c 8b 65 d0 e9 1f ff ff ff 48 83 7f 30 00 0f 85 3e fe ff ff <0f> 0b b8 ea ff ff ff e9 29 ff ff ff be c3 00 00 00 48 c7 c7 ff


以下のようなログも出力していたので、多分デバイス名の付け方に問題があったのだろう。

[4394230.181916] WARNING: at fs/sysfs/dir.c:530 sysfs_add_one+0xa5/0xd0()
[4394230.181921] sysfs: cannot create duplicate filename '/class/block/xvdt'
[4394230.181925] Modules linked in:
[4394230.181931] CPU: 0 PID: 19 Comm: xenwatch Not tainted 3.10.35-43.137.amzn1.x86_64 #1
[4394230.181937]  0000000000000009 ffff880024937b50 ffffffff8143c559 ffff880024937b88
[4394230.181945]  ffffffff8104bac1 00000000ffffffef ffff88000358acb0 ffff880024937c38
[4394230.181961]  ffff880024aad000 0000000000000001 ffff880024937be8 ffffffff8104bb2c
[4394230.181969] Call Trace:
[4394230.181986]  [<ffffffff8143c559>] dump_stack+0x19/0x1b
[4394230.181995]  [<ffffffff8104bac1>] warn_slowpath_common+0x61/0x80
[4394230.182000]  [<ffffffff8104bb2c>] warn_slowpath_fmt+0x4c/0x50
[4394230.182015]  [<ffffffff811e9955>] sysfs_add_one+0xa5/0xd0
[4394230.182020]  [<ffffffff811ea5a5>] sysfs_do_create_link_sd+0x105/0x200
[4394230.182026]  [<ffffffff811ea6c1>] sysfs_create_link+0x21/0x40
[4394230.182041]  [<ffffffff81311de4>] device_add+0x3e4/0x6d0
[4394230.182047]  [<ffffffff81310517>] ? dev_set_name+0x47/0x50
[4394230.182061]  [<ffffffff812459fd>] add_disk+0x1bd/0x4a0
[4394230.182068]  [<ffffffff81324a1d>] blkback_changed+0xd3d/0x1010
[4394230.182084]  [<ffffffff812da098>] xenbus_otherend_changed+0x98/0xa0
[4394230.182091]  [<ffffffff812dc083>] backend_changed+0x13/0x20
[4394230.182097]  [<ffffffff812d9436>] xenwatch_thread+0xb6/0x170
[4394230.182110]  [<ffffffff81070e10>] ? wake_up_bit+0x30/0x30
[4394230.182117]  [<ffffffff812d9380>] ? unregister_xenbus_watch+0x230/0x230
[4394230.182124]  [<ffffffff8106fee0>] kthread+0xc0/0xd0
[4394230.182137]  [<ffffffff8106fe20>] ? kthread_create_on_node+0x120/0x120
[4394230.182145]  [<ffffffff8144a12c>] ret_from_fork+0x7c/0xb0
[4394230.182157]  [<ffffffff8106fe20>] ? kthread_create_on_node+0x120/0x120

まとめ

AWS 的には、EBSを何個つけても問題なさそうだが、実際にたくさんEBSを付ける場合にはいろいろ考慮が必要なようだ。

2014年5月12日月曜日

RDSのMySQL でリードレプリカを作成するときの3つのポイント

RDS-MySQL のリードレプリカ

MySQL には、多くの皆さんがご存じのとおり、リードレプリカという機能がある。
簡単に言うと DB のコピーを自動的にとってくれる機能なのだが、普通に設定すると結構煩雑でちょっと面倒臭い。

Amazon Web Service (以下AWS) で、提供している RDS というサービスで、MySQL を利用することができる。このサービスではリードレプリカも簡単に設定できるようになっている。
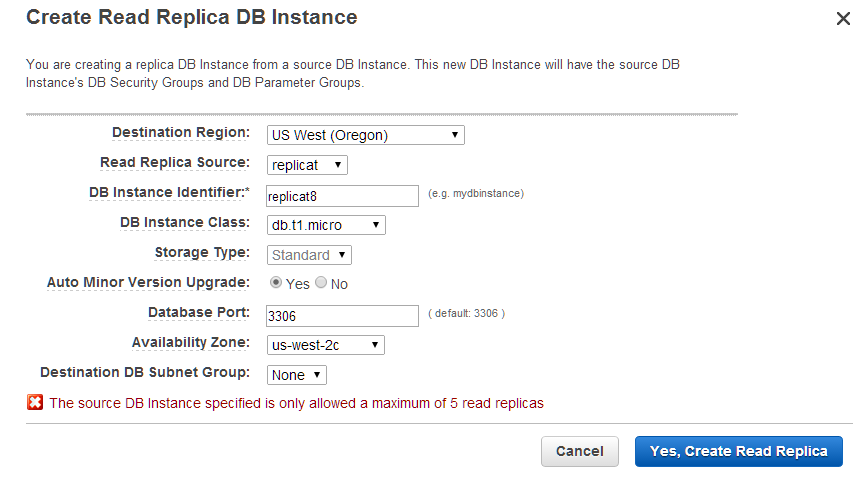
以下のようにメニューから選んで、必要項目を入力するだけでとっても簡単。


リードレプリカをたくさん作る

たくさんの参照があって書き込みが少ないデータベース、例えば Word Press のバックエンド等ではたくさん、リードレプリカを作って負荷分散することが効果的なケースがある。

このとき RDS を利用すると簡単にたくさんのリードレプリカを作成できて、非常に便利。だがいくつか制限がある。

一つのマスターに対して作成できるリードレプリカは5つまで

一つのマスターに対して作成できるリードレプリカは5つまで。この制限を超えると以下のようなエラーが出力される。

極端にリードレプリカをたくさん増やしても、マスターへのレプリケーションの負荷が増加するので、この制限もまぁ妥当なものだろう。

リードレプリカのリードレプリカ

ではもっとたくさん作りたい場合はどうすればいいかのか。答えはリードレプリカのリードレプリカを作成すればいい。

Automated Backups を Enabled にする

ただその場合、リードレプリカ側で Automated Backups が Enabled になっていなければいけない。


デフォルトでは Enabled になっていないので以下のようにレプリカを選択して右クリックから、 "modify" を選択して、"Backup Retention Period" を 1 以上に設定する。
これをしないとそもそも "Create Read Replica" をメニューから選択することもできない。


このときに "Apply Immediately" にチェックを入れておかないと次回のメンテナンスウィンドウか、手動で再起動されるまで、設定が反映されないので忘れずに。上の例では、ドロップダウンメニューの後ろに隠れている。

リードレプリカのリードレプリカは2段まで

ただし、リードレプリカは2段までしかできない。つまりリードレプリカのリードレプリカは作れるけれど、リードレプリカのリードレプリカのリードレプリカは作れない。作成しようとすると、以下のようなエラーが出力される。あんまり段数を増やしても今度はレプリケーションの遅延が大きくなるので、この制限はまぁ妥当なものだろう。


リードレプリカは全部で30個

マスターに対してリードレプリカは5個さらに5個のリードレプリカに対して5個ずつリードレプリカができるので2段目は 5 × 5 で、25 個。一つのマスターに対して合わせて30個のリードレプリカが作成できる。
ただし 30 個まで作れるものの実際のレプリケーションの負荷もばかにならないので、よっぽど書き込みが少ない場合も除いて実際の参照用として利用できるのは2段目の25個だけだと思っていい。
また2段目まで書き込みが反映されるまでのレイテンシーも2倍以上になるので、この点も考慮する必要がある。

まとめ

RDSのリードレプリカを作成する際は以下の3つに注意する必要がある。
  1. 一つのマスターに対して5個まで。
  2. 多段レプリカは2段まで。
  3. Automated Backups を有効にする。

最後に

便利に見えるリードレプリカですが、コスト面や読み取り専用としてしか使えないなど不便なところもあるので、実際の運用としては先に以下の方法も検討した方がよい。
  • インスタンスのサイズ変更で対応できないか。
  • PIOPS を利用で改善できないか。
上記二つの方が、リードレプリカを作成するよりも簡単で効果が高い場合もあります。

2014年3月25日火曜日

AWS VPC で VPC 間接続がサポートされたので試してみた。

AWS で VPC間の接続(Peering) がサポートされたので試してみました。
現在同一リージョン内のみで接続可能です。

今回不幸にも Management Console の更新が出ていたにも関わらず、うっかり NO とか 押してしまったためにコマンドライン(ec2-apitool)で実行してみました。
aws cli は、git 版も含めて現在サポートされていないようです。

まずec2-apitoolを最新化します。現在 1.6.13.0 でピアリング関係のコマンドが追加されています。
以下はAWS LINUXで標準でインストール されているコマンドを置き換える例です。
$ wget http://s3.amazonaws.com/ec2-downloads/ec2-api-tools.zip
$ cd /opt/aws/apitools
$ sudo unzip ~/ec2-api-tools.zip
$ sudo mv ec2-api-tools-1.6.13.0 ec2-1.6.13.0
$ sudo rm -f ec2
$ sudo ln -s ec2-1.6.13.0 ec2
$ cd ec2/bin
$ sudo rm -f *.cmd
$ cd /opt/aws/bin
$sudo find /opt/aws/apitools/ec2-1.6.13.0/ -iname "ec2-*" -exec ln -f -s {} . \;
VPC はマネージメントコンソールで適当に作成しておきます。 今回は異なるアカウント間で試してみました。
ピアリングのリクエストは以下のコマンドラインで設定します。 $ ec2-create-vpc-peering-connection --region us-west-2 -c vpc-526xxxxx -p vpc-576bxxxx -o 1xxxxxxxxxx0
VPCPEERINGCONNECTION pcx-e96xxxxx Tue Apr 01 11:42:46 UTC 2014 initiating-request: Initiating Request to 1xxxxxxxxxx0
REQUESTERVPCINFO vpc-526xxxxx 10.1.0.0/16 4xxxxxxxxxx6
ACCEPTERVPCINFO vpc-576bxxxx 1xxxxxxxxxx0
ec2-create-vpc-peering-connection
  • --region : リージョンを指定します。今回はoregon を使用しました。
  • -c : 接続元のvpc-id を指定します。
  • -r : 接続先のvpc-id を指定します。
  • -o : 接続先のアカウントIDを指定します。

VPC ピアリングコネクション ID ( pcx-e96xxxxx ) を控えて、接続先に連絡します。
ピアリングリクエストをアクセプトするためには、接続先のアカウントで以下の コマンドを実行します。 $ ec2-accept-vpc-peering-connection --region us-west-2 pcx-e96xxxxx
VPCPEERINGCONNECTION pcx-e96xxxxx provisioning: Provisioning
REQUESTERVPCINFO vpc-526xxxxx 10.1.0.0/16 4xxxxxxxxxx6
ACCEPTERVPCINFO vpc-576bxxxx 10.0.0.0/16 1xxxxxxxxxx0
ec2-create-vpc-peering-connection
  • --region : リージョンを指定します。
  • pcx-e96xxxxx : 先ほど控えた VPC ピアリングコネクション ID
さらに接続元、接続先でルーティングテーブルにエントリを追加します。
[接続元]
$ec2-create-route --region us-west-2 rtb-e67xxxxx -r 10.1.0.0/16 -p pcx-e96xxxxx
ROUTE 10.0.0.0/16 pcx-e96xxxxx
[接続先]
$ec2-create-route --region us-west-2 rtb-187xxxxx -r 10.1.0.0/16 -p pcx-e96xxxxx
ROUTE 10.1.0.0/16 pcx-e96xxxxx
ec2-create-vpc-peering-connection
  • --region : リージョンを指定します。
  • -r : 相手ネットワーク の CIDRブロックを指定します。 VPC 全体でも、サブネットでもかまいません。
  • -p : VPC ピアリングコネクション ID を指定します。
両方合わせてわずか、4コマンドで接続できました。詳細は現在英語版だけですが、マニュアルを参照してください。

2014年3月3日月曜日

電力効率がいいワークキューって?

 Linux Foundation の LTSI(Long Term Support Initiative) v3.10 公開 という記事のなかで、 "電力効率のよい workqueue" という機能がマージされたとのこと。
なぜ workqueue の変更で電力効率が変わるんだ? ということで調べたメモ。
※K.T. さん情報提供ありがとうございます。

workqueue

workqueue というのは、簡単にいうとLinux カーネルのなかで処理を遅延させる 仕組みのこと。
LINUX kernelに限らず、現代のOSは機能が豊富でたくさんの仕事をしなければいけない。

一方でOSは通常のプロセスとは違い特権モードで動作しているので、 あんまりお仕事をしすぎるとユーザープロセスの動作が遅れてしまう。

本来OSの利用者は、自分のプロセスが高速に動作することを期待しているので、 OSがお仕事しすぎてユーザープロセスが遅れては本末転倒である。

そこでOSのお仕事のうち、待ちが発生するものや、今すぐにやらなくてもいいこと を順番待ちに登録(queueing)して、後から適切な時に実行するのが workqueue という仕組み。

なんで仕事の順番を替えるだけで、電力消費が減るんだろう?というのが今回の 疑問。その前に少しだけ、MPUのお話。

big.LITTLE処理

最近のARMプロセッサでは「big.LITTLE処理」という機能が搭載されている。 これは簡単に言うと、高速で消費電力が大きい(big)プロセッサ(ARM Cortex™-A15プロセッサ) と、低速で消費電力が小さい(LITTLE)プロセッサ(Cortex™-A7)を両方搭載して、 処理の内容や、タイミングなどによって使い分けようという考え方。

電力効率のよい workqueue

この"big.LITTLE処理" を workqueue に適用して、できるだけLITTLE側に処理を 振ることで電力効率を改善するというのが今回マージされた機能ということに なる。わかってみればそれほど難しい話ではない。

一般のスケジューラでは?

処理をできるだけ LITTLE 側に振るだけで、電力消費が減るならば一般のプロセス スケジューラでも適用できるのでは?と思ってちょっと調べてみた。
現在、IKS と呼ばれる方式と、GTS(big.LITTLE MP)と呼ばれる2つの方式が 提案されているようだ。IKS は cpufreq という電力管理の延長線上で big と LITTLE の切り替えを行う方式。

GTS は、スケジューラ(sched) に変更を加えてbig と LITTLEにプロセスを 割り当てる方式。

さすがに sched に手を入れた場合は影響範囲が大きいのでメインストリーム には取り込まれておらず、特定の機器で取り込まれている模様。

SMP でない環境でのスケジューリングはいろいろ議論があって面白そう。

参考

workqueue については例えば、以下のIBM developerWorks の記事などを参照
「カーネル API: 第 2 回、遅延可能な関数、カーネルのタスクレット、およびワークキュー」
http://www.ibm.com/developerworks/jp/linux/library/l-tasklets/

big.LITTLE処理
http://www.arm.com/ja/products/processors/technologies/biglittleprocessing.php

後藤弘茂のWeekly海外ニュース
「 2014年のARMのSoCの中核技術となる「big.LITTLE MP」」
http://pc.watch.impress.co.jp/docs/column/kaigai/20131220_628480.html

Linaro Blog 「big.LITTLE Software Update」
http://www.linaro.org/linaro-blog/2013/07/10/big-little-software-update/

LWN.net「 Queue work on power efficient wq 」
http://lwn.net/Articles/548281/

2014年2月27日木曜日

/proc/diskstats のメモ

こんな簡単なメモでも誰かの役に立つかもしれない
RHEL 6 kernel-2.6.32-431.5.1.el6.src.rpm から。
Field No.変数簡単な説明タイプ単位関数
1MAJOR(part_devt(hd))メジャー番号
2MINOR(part_devt(hd)マイナー番号
3disk_name(gp, hd->partno, buf)ディスク名
4ios[0]完了済み読み込みIO数カウンター個blk_account_io_done
5merges[0]マージ済み読み込みIO数カウンター個drive_stat_acct
6sectors[0]完了済み読み込みセクター数カウンター個blk_account_io_completion
7ticks[0]読み込みで使用された秒数カウンターミリ秒blk_account_io_done
8ios[1]完了済み書き込みIO数カウンター個blk_account_io_done
9merges[1]マージ済み書き込みIO数カウンター個drive_stat_acct
10sectors[1]完了済み書き込みセクター数カウンター個blk_account_io_completion
11ticks[1])書き込みで使用された秒数カウンターミリ秒blk_account_io_done
12part_in_flight(hd)実行中のIO数ゲージ個drive_stat_acct,blk_account_io_done
13io_ticksIOにかかった時間カウンターミリ秒drive_stat_acct
14time_in_queueキューにIOがあった合計時間 (in_flight x io_ticks の合計)カウンターミリ秒drive_stat_acct
blk_finish_request
->blk_account_io_done
─────────────────────
2003  unsigned long duration = jiffies - req->start_time;
2011  part_stat_inc(cpu, part, ios[rw]);
2012  part_stat_add(cpu, part, ticks[rw], duration);
2013  part_round_stats(cpu, part);
2014  part_dec_in_flight(part, rw);
2015
─────────────────────

blk_update_request
->blk_account_io_completion
──────────────────────────
1981static void blk_account_io_completion(struct request *req, unsigned int bytes)
1982{
1983 if (blk_do_io_stat(req)) {
1984  const int rw = rq_data_dir(req);
1985  struct hd_struct *part;
1986  int cpu;
1987
1988  cpu = part_stat_lock();
1989  part = disk_map_sector_rcu(req->rq_disk, blk_rq_pos(req));
1990  part_stat_add(cpu, part, sectors[rw], bytes >> 9);
1991  part_stat_unlock();
1992 }
1993}
──────────────────────────

blk_insert_request
blk_queue_bio
blk_insert_cloned_request
->drive_stat_acct
──────────────────────────
1199static void part_round_stats_single(int cpu, struct hd_struct *part,
1200        unsigned long now)
1201{
1202 if (now == part->stamp)
1203  return;
1204
1205 if (part_in_flight(part)) {
1206  __part_stat_add(cpu, part, time_in_queue,
1207    part_in_flight(part) * (now - part->stamp));
1208  __part_stat_add(cpu, part, io_ticks, (now - part->stamp));
1209 }
1210 part->stamp = now;
1211}
──────────────────────────